Réponse rapide
Choisissez le réseau d’une agence à partir du travail à protéger, puis testez les scénarios de panne avant de signer. Cartographiez les équipements, le câblage, l’alimentation et les dépendances opérateur de chaque site ; prévoyez une liaison principale et un secours réellement indépendant ; donnez la priorité aux paiements et aux systèmes opérationnels ; séparez et sécurisez les flux ; convenez d’une escalade ; conservez enfin un journal daté des pannes et des tests. Deux opérateurs ne signifient pas automatiquement deux chemins.
Quand la connexion d’une agence tombe, le problème n’est pas simplement « Internet ». Un paiement peut rester en attente, les stocks ne plus se mettre à jour, un client patienter, un soignant perdre l’accès à un dossier ou le siège ne plus joindre son équipe.
C’est pourquoi une entreprise qui ouvre une agence à Abidjan, étend son réseau depuis Dakar, ou accompagne des bureaux à Douala et Kinshasa doit choisir son infrastructure en partant du mauvais jour. Le débit annoncé n’est qu’un élément. La vraie question est la suivante : quel travail doit continuer, malgré quelle panne, et avec l’aide de qui ?
Commencez par le travail que la connexion doit soutenir
Décrivez les tâches de chaque agence avant de demander à un fournisseur de proposer une liaison ou un routeur. Une agence commerciale peut avoir besoin de l’encaissement par carte ou mobile money, de la mise à jour des stocks, d’un point de vente, de la messagerie du personnel et d’un canal de service client. Un hôtel ou un restaurant ajoutera les réservations, la téléphonie, le Wi-Fi des clients et les échanges avec les fournisseurs. Une école, une clinique ou un cabinet peut dépendre de dossiers cloud, de réunions vidéo, du partage de fichiers et d’un accès sécurisé au siège.
Classez ensuite ces tâches selon leur comportement attendu pendant une interruption :
- Doit continuer : paiements, contact d’urgence ou service client, mises à jour essentielles des stocks ou réservations, et systèmes qui protègent les personnes et les fonds.
- Doit continuer en mode réduit : téléphonie, travail cloud courant, messagerie interne et petite synchronisation des données.
- Peut attendre ou perdre en qualité : grosses sauvegardes, visioconférences, téléchargements de logiciels, navigation des visiteurs et envoi de fichiers non urgent.
Cette hiérarchie donne au réseau une finalité opérationnelle. Elle vous donne aussi une meilleure question à poser : « Que deviennent les paiements lorsque la liaison principale tombe ? » vaut mieux que « Quel débit obtenons-nous ? »
Faites l’étude de chaque site avant de comparer les devis
Un réseau multi-sites est un ensemble de lieux physiques, pas un schéma dessiné depuis le siège. Parcourez chaque agence et notez l’arrivée du service, les pièces, les murs, les plafonds, les emplacements des équipements, les parcours des câbles, les zones sans Wi-Fi, les prises et les espaces sécurisés.
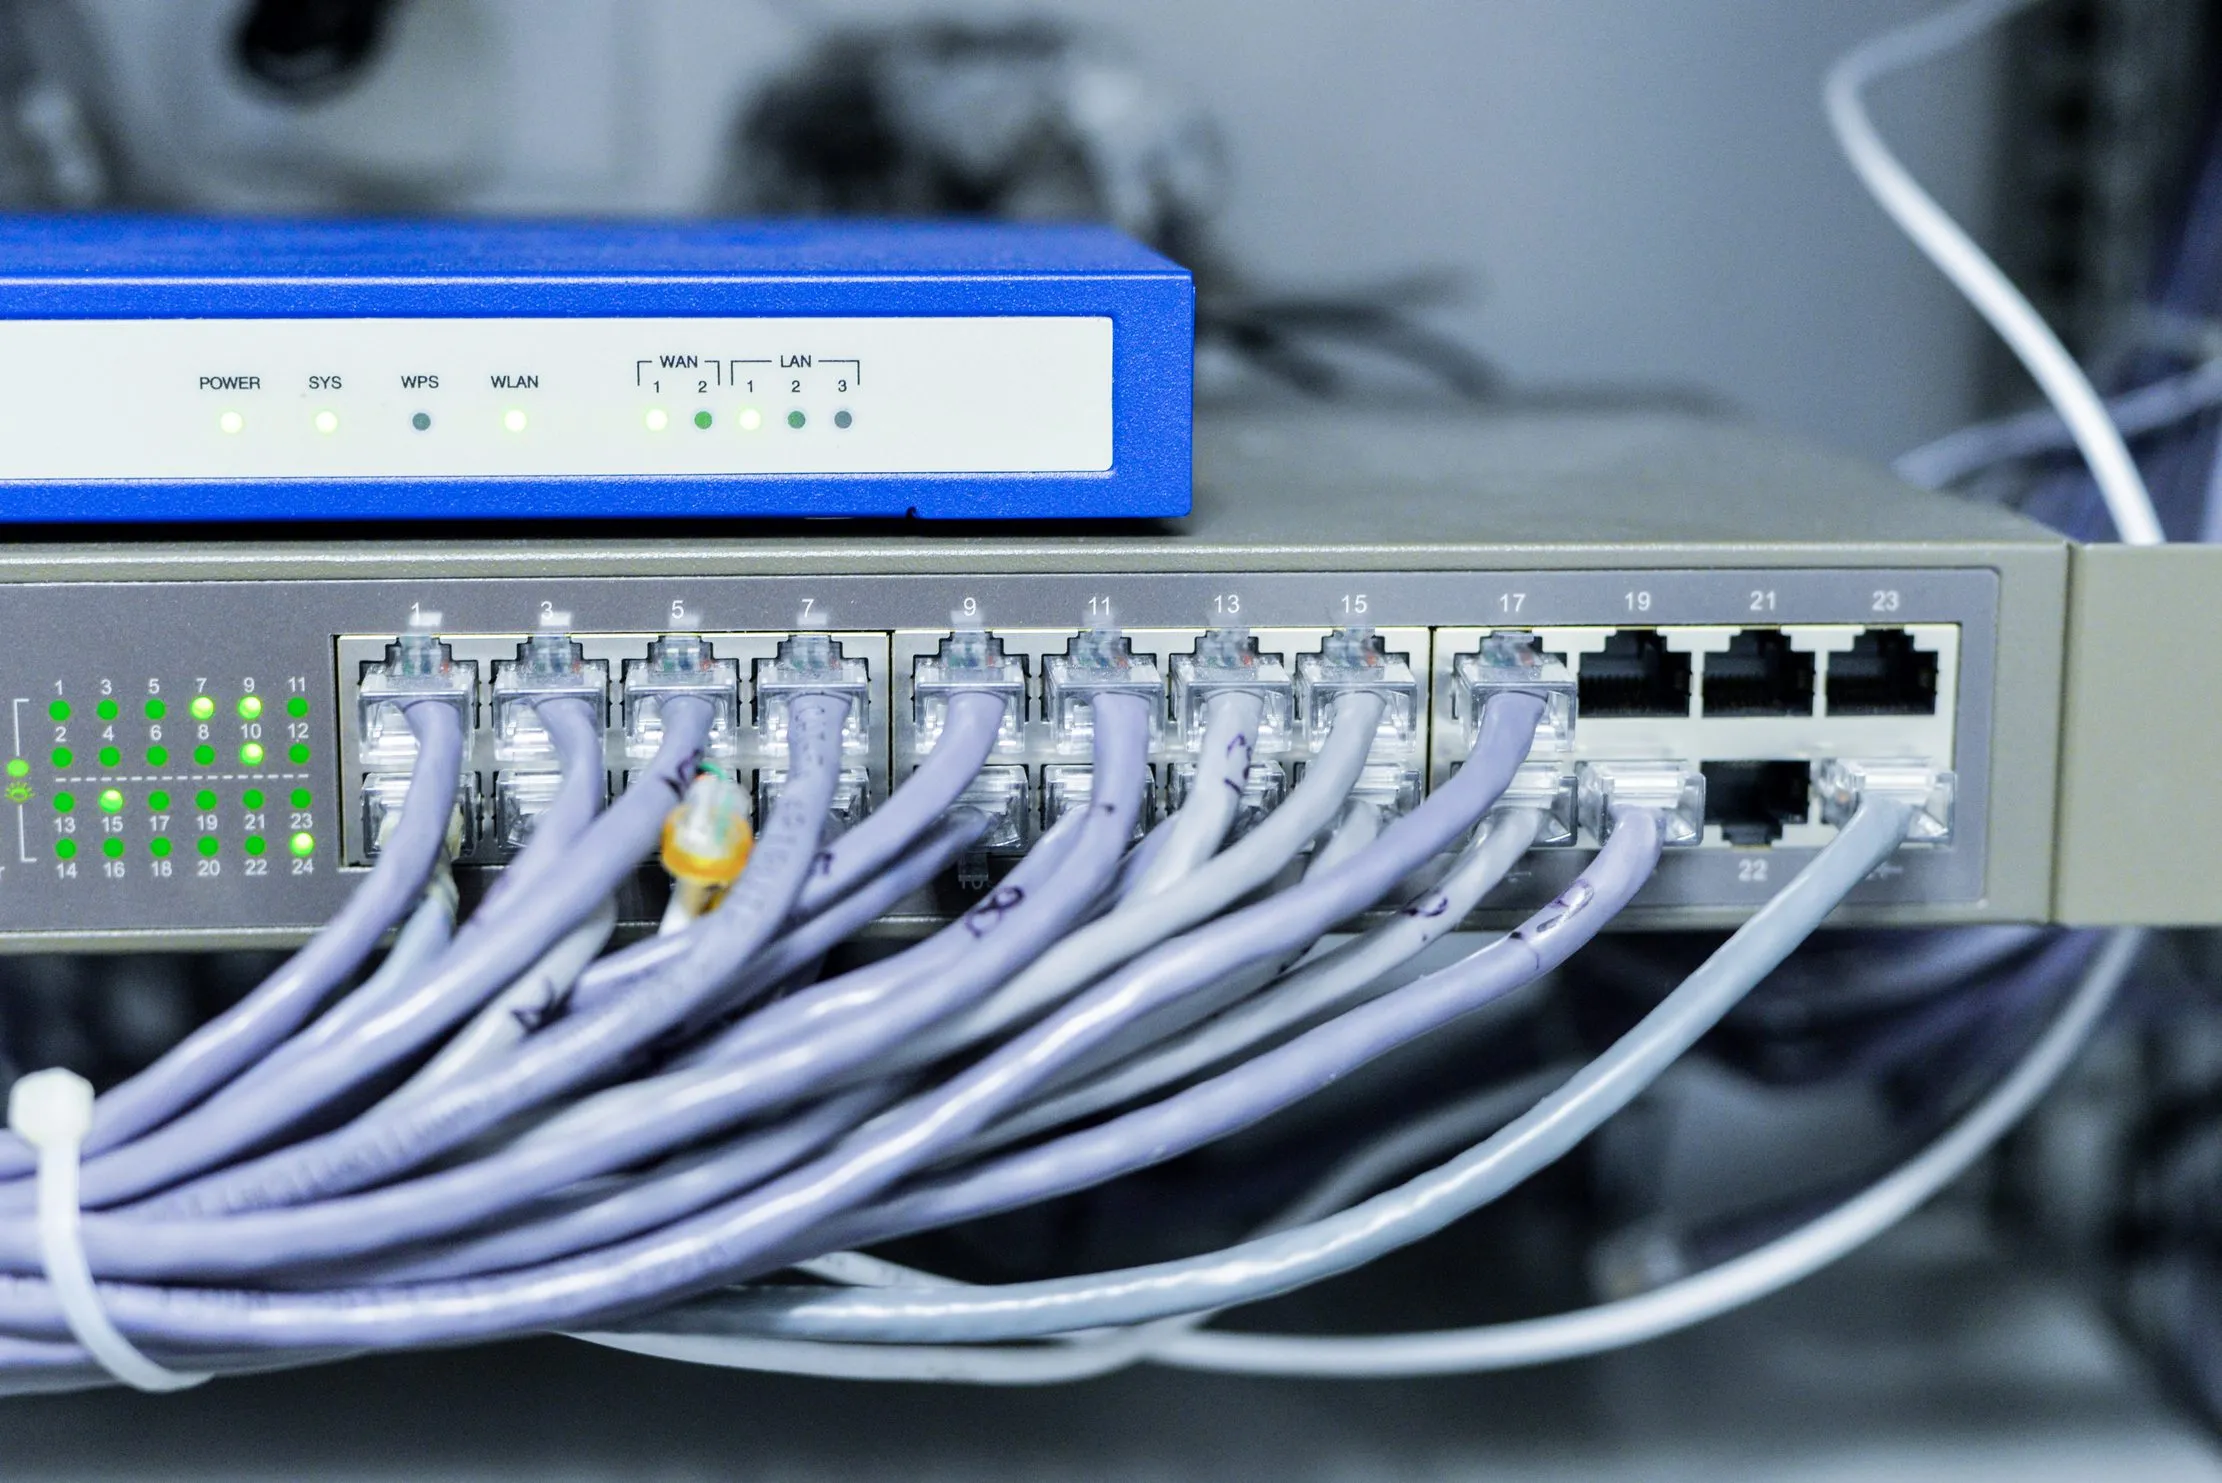
Établissez une carte des équipements et du câblage : routeur, pare-feu, commutateurs, bornes Wi-Fi, caisses, imprimantes, caméras, téléphones, serveurs, ordinateurs du personnel et équipements critiques de tiers. Indiquez les appareils protégés par un onduleur ou une autre solution électrique, ceux qui sont enfermés, et ceux qui dépendent d’un seul commutateur, d’une seule baie ou d’une seule prise.
Demandez au fournisseur de documenter son point de remise, le chemin d’accès, les dépendances amont, la procédure d’assistance et la limite de responsabilité. Si l’étude ne permet pas de savoir où la liaison entre dans le bâtiment ou quels équipements l’opérateur contrôle, gardez cette lacune visible dans votre tableau de comparaison.
Rendez la liaison de secours réellement indépendante
Une liaison principale et une liaison de secours ne sont utiles que si elles ne tombent pas pour la même raison. Comparez le support, l’opérateur, l’entrée dans le bâtiment, les équipements locaux, la source électrique, le transport amont et le chemin physique. Une liaison fibre et un second service d’une autre entreprise peuvent partager une gaine, un poteau, une route, un immeuble, un central ou un point de présence.
Les recommandations de la CISA sur la résilience des communications attirent l’attention sur la diversité des chemins et les installations communes : deux services peuvent coexister sans supprimer le même point de défaillance. Demandez à chaque opérateur les informations nécessaires pour comparer les itinéraires. Si la dépendance ne peut pas être confirmée, classez le secours « opérateur différent, chemin non vérifié », et non « totalement indépendant ».
Vérifiez également le basculement lui-même. Le pare-feu change-t-il automatiquement de liaison ? Le VPN inter-sites, les terminaux de paiement, la téléphonie, les applications cloud et les contrôles de sécurité récupèrent-ils ? Le secours dépend-il d’un volume de données ou d’une alimentation qui le rend inadapté à une longue panne ? Une liaison présente sur le devis mais jamais utilisée avec les flux prioritaires n’est pas encore un secours testé.
Donnez la priorité aux flux avant la panne
Lorsque la liaison de secours est plus petite ou plus coûteuse, l’agence a besoin de règles. Placez les paiements, les stocks, les réservations, les dossiers patients ou élèves, la téléphonie professionnelle et les accès distants approuvés devant la navigation des visiteurs, le divertissement, les gros téléchargements et les sauvegardes volumineuses.
Utilisez, lorsque les équipements et le risque le justifient, des segments séparés pour le personnel, les visiteurs, les terminaux de paiement ou équipements opérationnels, les caméras et l’administration de l’infrastructure. Appliquez des règles de qualité de service aux flux qui doivent rester utilisables. Programmez les grosses sauvegardes en dehors des heures chargées ou utilisez un chemin séparé lorsque le réseau le permet.
La règle doit rester compréhensible. Le responsable de l’agence doit savoir ce qui reste disponible pendant le basculement, ce qui est volontairement limité et qui peut approuver une modification temporaire. Une règle complexe que personne ne sait expliquer sera difficile à appliquer sous pression.
Intégrez la sécurité à la résilience
Un réseau disponible qui expose l’entreprise n’est pas résilient. Demandez au minimum qui va :
- modifier les identifiants par défaut, protéger les comptes administrateur avec la MFA lorsque c’est possible, et intégrer les routeurs, pare-feux et bornes Wi-Fi dans une routine de mise à jour ;
- séparer les flux visiteurs et opérationnels, limiter les accès entre agences, et revoir les droits d’administration à distance ;
- enregistrer les événements du pare-feu, l’état des liaisons, les basculements et les changements de configuration avec une heure exploitable ;
- exporter les configurations chiffrées des équipements et conserver hors ligne une copie du plan réseau, des contacts et des étapes de récupération ;
- protéger la baie de communication, l’onduleur et le matériel de rechange contre l’accès non autorisé, la chaleur, l’eau et les dommages électriques évitables.
Les objectifs de cybersécurité de la CISA pour les petites organisations et son guide sur les rançongiciels relient schémas réseau, segmentation, contrôle des accès, sauvegardes et récupération. Ils rappellent que la résilience consiste aussi à comprendre, contenir et reconstruire le réseau — pas seulement à voir les voyants du routeur allumés.
Achetez une assistance et une escalade, pas seulement du matériel
Écrivez le circuit d’assistance avant l’installation. Nommez le contact de l’agence, le responsable interne, le mainteneur réseau, l’opérateur principal, l’opérateur de secours, le fournisseur de matériel et le décideur qui peut approuver une solution d’urgence.
Demandez comment une panne est enregistrée, quelles informations l’opérateur attend, comment le dossier est escaladé, à quel moment une intervention sur site devient nécessaire et comment les mises à jour vous sont communiquées. Ne vous contentez pas de la promesse informelle que quelqu’un « va regarder ». Faites inscrire le canal de communication, le périmètre d’assistance, les notifications de maintenance, la responsabilité du remplacement et les conditions contractuelles.
Conservez une fiche d’exploitation d’une page dans chaque agence. Elle doit indiquer les vérifications sans danger, les éléments qu’il ne faut pas débrancher, la manière de confirmer le basculement, la protection des paiements en attente et le bon contact à appeler. L’approche de planification de la continuité du NIST est utile ici : identifier les fonctions essentielles, définir les procédures alternatives, attribuer les responsabilités et exercer le plan.
Inscrivez les tests au calendrier
Le test doit être planifié, et non improvisé après la première panne sérieuse :
- Chaque mois : confirmer les alertes de supervision, les contacts, les sauvegardes de configuration et la dernière preuve de basculement réussi.
- Chaque trimestre : tester le changement de liaison d’une agence dans une fenêtre convenue, avec les applications prioritaires, le VPN, la téléphonie, le paiement et le retour à la liaison principale.
- Deux fois par an : jouer un scénario plus long, par exemple une panne opérateur avec coupure électrique, remplacement du routeur ou câble endommagé. Faites participer l’équipe locale et l’assistance.
- Après toute modification importante : mettre à jour le plan et la fiche d’exploitation, puis tester le chemin, la règle de pare-feu, l’équipement, l’opérateur ou l’application concernés.
Consignez le résultat, pas seulement la date. Un test qui échoue devient une preuve utile lorsqu’il produit un responsable et une correction. Une coche verte sans élément vérifiable n’est qu’une hypothèse.
Conservez un journal des pannes pour décider d’une évolution
Utilisez un petit journal dans chaque agence. Il peut prendre la forme d’un tableur contrôlé ou d’un outil de tickets, à condition de rester consultable lorsque le réseau est indisponible. Gardez aussi une copie papier ou hors ligne des contacts nécessaires à la première réaction.
| Date / agence | Début / fin | Déclencheur | Services touchés | Contournement / ticket | Responsable / suite |
|---|---|---|---|---|---|
| ________ | ________ | opérateur / énergie / routeur / câble / inconnu | paiements / stocks / voix / cloud / autre | ________ | ________ |
| ________ | ________ | opérateur / énergie / routeur / câble / inconnu | paiements / stocks / voix / cloud / autre | ________ | ________ |
Relisez le journal chaque mois et avant le budget. Cherchez le temps d’arrêt total, les déclencheurs répétitifs, les agences qui dépendent du même chemin, les basculements échoués et le travail manuel qui crée un risque financier ou de service. Une évolution peut signifier un autre itinéraire physique, une meilleure protection électrique, un pare-feu mieux administré, un nouveau câblage, un secours plus adapté, une assistance plus claire ou une modification de procédure. Elle ne signifie pas automatiquement acheter davantage de débit.
La décision finale est un plan d’exploitation testé
Avant d’approuver un réseau multi-sites, demandez cinq éléments : une étude de site, une carte des équipements et du câblage, une conception principale-secours avec ses dépendances, une politique de flux et de sécurité, ainsi qu’un plan d’assistance et de tests. Ajoutez le journal des pannes dès que la première agence est en production.
La meilleure architecture n’est pas celle qui porte la spécification la plus longue. C’est celle que l’équipe locale comprend, que le fournisseur sait assister et que l’organisation a déjà testée un jour où cela dérangeait. C’est ainsi que la connectivité devient une continuité d’activité, au lieu de rester un nouveau point unique de défaillance.
Questions fréquentes
Deux fournisseurs d’accès garantissent-ils la résilience ?
Non. Deux fournisseurs peuvent partager une route, un immeuble, un central, une source électrique, un opérateur amont ou une autre installation. Demandez les chemins physiques et logiques, pas seulement deux factures, puis testez le basculement dans une fenêtre maîtrisée.
Une connexion mobile suffit-elle comme liaison de secours ?
Elle peut convenir pour les tâches essentielles et peu consommatrices de données, mais cela dépend du site, de l’équipement, du signal, de l’alimentation, des contrôles de données et des conditions du fournisseur. Testez les paiements, les stocks, la téléphonie, le VPN et les applications cloud avant de compter dessus.
À quelle fréquence faut-il tester le basculement ?
Inscrivez les tests au calendrier au lieu d’attendre une panne. Vérifiez chaque mois la supervision et le changement de liaison, faites chaque trimestre un exercice dans une agence et incluant l’alimentation et la récupération du routeur, puis réalisez au moins deux fois par an un scénario plus large ou après une modification importante.
Que doit contenir une étude de site ?
Elle doit recenser le bâtiment, les pièces, les équipements, le câblage, les points d’entrée, le routeur, les commutateurs, les bornes Wi-Fi, la protection électrique, la remise opérateur, les liaisons inter-sites, les applications critiques et les dépendances connues. Elle doit aussi signaler ce qui reste non documenté ou non testé.
Sources et chercheurs à citer
Cet article s’appuie sur l’extrait fourni de MCT4SD 2025, Volume 3, pour son approche des technologies distribuées et de la résilience, ainsi que sur le livre de Stéphane Duguin pour l’importance accordée aux conséquences opérationnelles, aux ressources limitées, à la préparation et à la récupération. La CISA et le NIST apportent les repères pratiques sur la diversité des chemins, les dépendances, la continuité et les tests. La liste de contrôle est une synthèse opérationnelle de Peter Bamuhigire ; elle ne promet ni fournisseur, ni débit, ni disponibilité, ni délai de réparation. Vérifiez le projet selon chaque site, contrat, secteur et obligation locale applicable. Sources vérifiées le 10 septembre 2026.
- Springer Nature — MCT4SD 2025, Volume 3
- Stéphane Duguin — Cybersecurity for NGOs: Attack Prevention and Threat Response
- CISA — Public Safety Communications Network Resiliency Self-Assessment Guidebook
- NIST — SP 800-34 Rev. 1, Contingency Planning Guide
- CISA — Cross-Sector Cybersecurity Performance Goals
À lire ensuite
Le cycle de vie sur quatre ans des ordinateurs de bureau
Relier le choix du réseau aux appareils, à l’alimentation et aux dossiers d’assistance de chaque agence.
Les 24 premières heures après un hameçonnage
Préparer les personnes et les gestes utiles lorsqu’un incident de réseau ou de compte touche l’activité.
Revoir votre plan TIC opérationnel
Réunir agences, systèmes, contrôles et responsabilités d’assistance dans une revue pratique.
About the author
Peter Bamuhigire
Architecte logiciel et consultant TIC — systèmes d’entreprise en Afrique
Peter Bamuhigire aide les organisations à transformer leurs décisions technologiques en méthodes de travail opérationnelles. Pour les équipes multi-sites, il s’intéresse au point de rencontre entre connectivité, paiements, stocks, applications cloud, équipes locales et responsabilités d’assistance — surtout lorsqu’une agence doit continuer à servir pendant une panne.